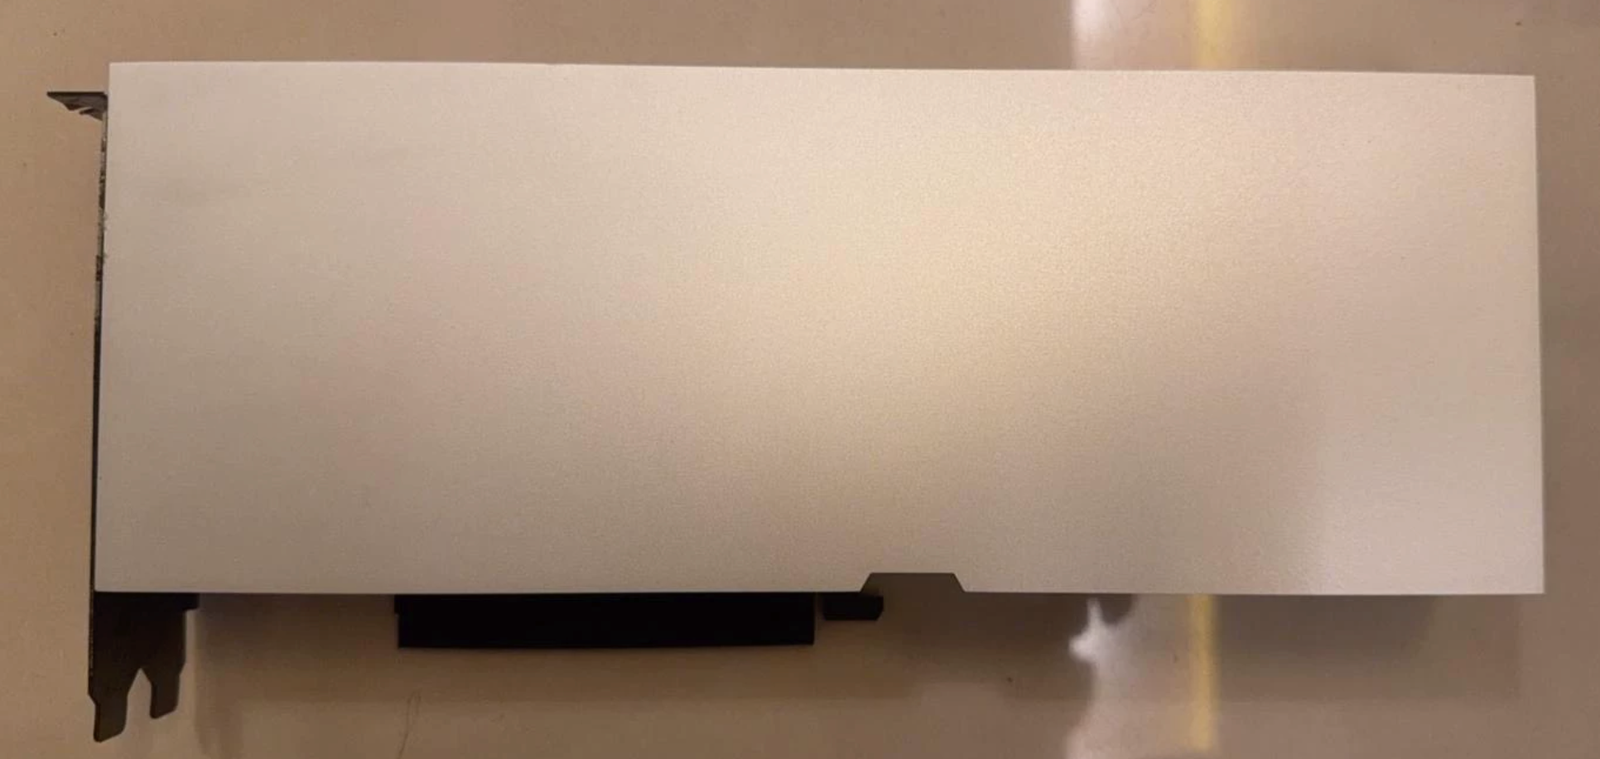
Qwen3.8-27B 是大约 27B 的密集模型,混合了注意力和 Mamba。我们用 vLLM,在一张 64 GB 的 CMP170HX 上跑它的 W4A16。热态、短输出、24 路并发时,解码总吞吐是 992 tok/s,平均每路大约 54 tok/s。单路大约 94 到 129 tok/s。
这个大约 1000 tok/s,是 24 路加在一起的数字,不是一条请求自己每秒能写出一千个 token。
卡上实际放了什么
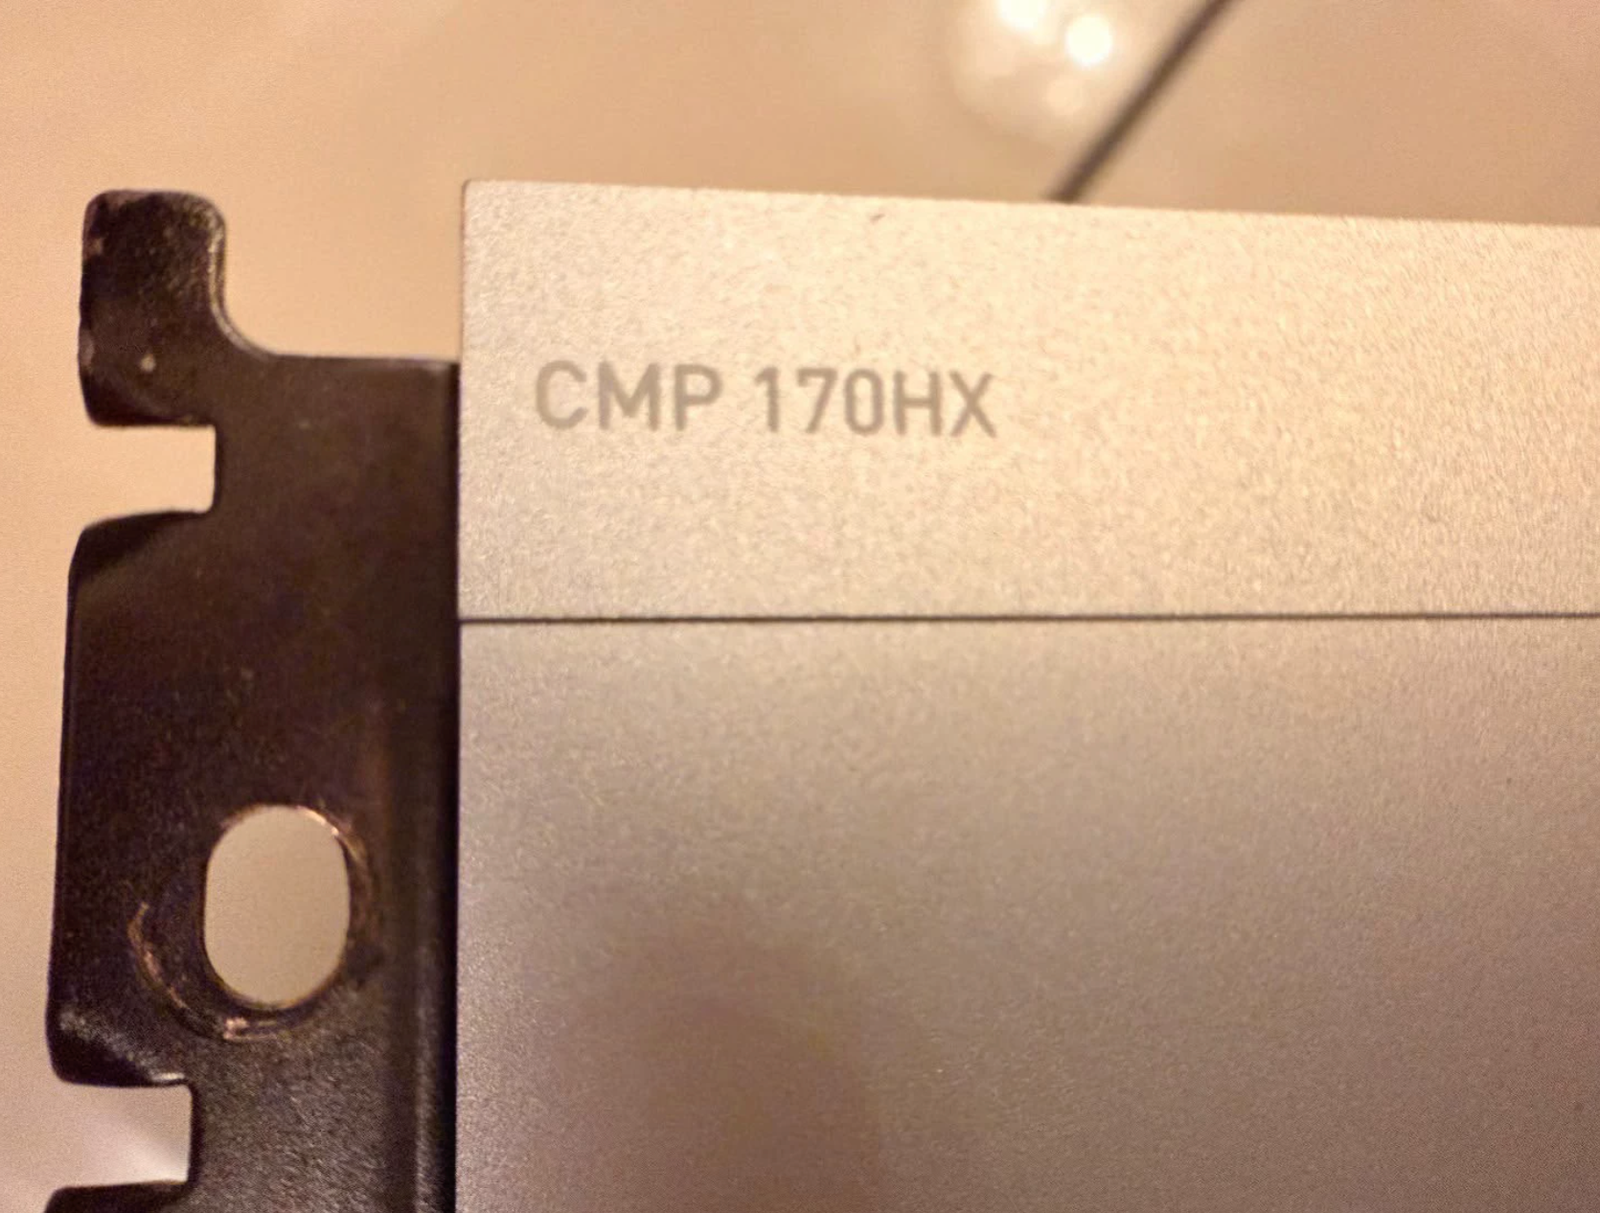
量化是 W4A16,权重大约 16 GiB。上下文开到 262K。混合架构的分页大小是 800 个 token。
64 GB 的卡装完权重之后,还给 KV 留了比较宽裕的空间。我们测下面这些解码吞吐时,用的就是这档卡。权重大约 16 GiB,40 GB 的卡也放得下权重和 262K 上下文,只是 GPU 里能同时留下的 KV 会少一截。后来在 40 GB 上看过一次池子:大约 19.37 GiB,能放下大约 290147 个 token。
解码用了 MTP1:模型每一步不只生成 1 个 token,而是附带预测后面几个,验证通过就能少算一段。MTP 越深,单路往往越快,但每一步要处理的 token 也越多,并发一乘,很容易把批大小顶满。底下的推理框架是 vLLM。
单路更快的配置,并发反而上不去
选配置的时候,对比过 MTP1 和 MTP3。
MTP3 单路更快:写代码大约 179 tok/s,中文大约 106,推理大约 208。MTP1 是大约 131、97、134。代码慢了大约 28%,推理慢了大约 35%,中文只差大约 9%。并发测试里,MTP1 的单路大约 127 tok/s。
但总吞吐是另一回事。MTP1 在 16 路能到大约 890 tok/s;同一时期 MTP3 只有大约 445,每路大约 36 tok/s。如果更看重同时服务的总输出,MTP1 更合适。
后来发现,这里还有一层加速图的限制。vLLM 默认只给 32 以内的批大小预编译加速图,超出就退回慢路径。MTP1 每路每步算 2 个 token,16 路正好是 32;MTP3 每路每步算 4 个 token,8 路就到 32 了。所以 MTP3 一开到 16 路就会掉下去,不完全是算力不够,而是走出了编译好的那条快路径。
把预编译上限提到 128 之后,MTP3 的 16 路回到大约 790 tok/s,24 路却只有大约 495;MTP1 的 24 路还能继续往上走。MTP4 单路更快,但代码、中文、推理三组输出都跟基准对不上,没有采用。
稳定配置下的并发数字
后来把核心偏移定在 +150,满载时温度大约 85°C,功耗顶在大约 300 W。配置是 MTP1、最多 24 路、读入块 8192、上下文 262K。这个设置下测到的解码吞吐是:
| 并发 | 总吞吐 | 每路速度 |
|---|---|---|
| 1 路 | — | 94 到 129 tok/s |
| 8 路 | 556 tok/s | 约 95 tok/s |
| 16 路 | 842 tok/s | 约 72 tok/s |
| 24 路 | 992 tok/s | 约 54 tok/s |
24 路的 992,是我们对外引用的那个数字。它和上一节配置选择时看到的更高值不是同一组条件,所以这里只报稳定偏移下测到的这张表。
长文读入大约 2300 到 2500 tok/s。预填充是读提示词,解码是往外生成。长文本往往会先花时间在读入和等待第一个 token 上,这两类数字要分开看。上面这张表测的是热态、短输出的解码总吞吐,262K 只是服务开着的上下文上限,并不表示 24 路各自填满了这个长度。
满载跑了 1 小时:输出校验每次都对得上,没有把这个结果建立在一次短测上。
长上下文被挤出 GPU 以后
短解码只是一半。另一半是:很长的前缀被后来的请求挤出 GPU 之后,下一次还要不要整段重算。
我们用 vLLM 的换回层,把挤出去的 KV 先放到主机内存,内存放不下再落到 NVMe,下次请求再搬回来。这条路在 vLLM 0.29 上走不通:KV 能写出去,读不回来,外部命中是 0。原因是当时开了 MTP 之后,混合架构里的几组 KV 会被一起标成草稿,换回查找对不上。公开记录在 vLLM issue 52735,后来的版本修了。我们用的是 0.33。
升级之后核过一次:大约 3.15 万 token 的独特前缀,冷启动 15.26 秒;把进程完全重启后再发,3.03 秒就回来,命中 30400 个 token。这不是 GPU 里残留的缓存,是磁盘读回来的。
内存层太小也不行。4 GiB 只能放下大约 60982 个 token。64K 的前缀被挤出后再请求,会整段重算大约 36 秒,命中是 0;128K 大约 89 秒。把内存层加到 14 GiB 之后,大约能放 21.5 万 token。用新生成的提示词验收:
| 规模 | 首次(冷启动) | 挤出后再请求 | 命中缓存 |
|---|---|---|---|
| 64K | 35.34 秒 | 5.68 秒 | 62400 |
| 200K | 169.05 秒 | 15.99 秒 | 198400 |
200K 从将近 3 分钟的重算,变成大约 16 秒载回来。路径是先从 NVMe 读进内存层,再搬回 GPU。如果前缀还留在 GPU 上,250K 的热缓存大约 2.63 秒就能接上,那是另一档速度。
有一个限制:如果 GPU 上的 KV 池比内存层更大,一次能把前缀挤出 GPU 的填充请求,也常常会把内存层整层换掉。所以这里测到的“挤出后再请求”,走的是磁盘回到内存、再回到 GPU,不是纯内存命中。
内存层如果更大,按这次 14 GiB 大约能放 21.5 万 token 的比例估算。下面两档不是另一次实测:
| 内存换回层 | 大约能放的 KV |
|---|---|
| 4 GiB(实测) | 约 60982 token |
| 14 GiB(实测) | 约 21.5 万 token |
| 64 GiB(按比例估算) | 约 98 万 token |
| 128 GiB(按比例估算) | 约 197 万 token |
64 GiB 已经大于我们在 40 GB 卡上看到的大约 29 万 token 的 GPU 池,也盖得住下面这档 64 GB 卡上更大的 GPU 池。被挤出 GPU 的前缀通常会留在内存里,再请求就是内存命中,日常不必再走磁盘。128 GiB 则可以同时多留几段长上下文:按 262K 上限粗算,64 GiB 大约能在内存里同时留下大约 3 段接近上限的前缀,128 GiB 大约 7 段。它们不会因此就能同时在 GPU 里解码:GPU 上同时热着多少 token,仍由显存里的 KV 池决定。内存层变大,只是让这些前缀被挤出去之后还能较快接上,不必整段重算。磁盘仍然有用:超出内存的部分可以继续往下落,进程重启后也能从盘上把前缀读回来。内存命中会比这次测到的磁盘路径(200K 大约 16 秒)更快,但具体速度取决于主机内存带宽,我们没有在 64 GiB 或 128 GiB 的换回层上复测。
如果用一张 64 GB 的 CMP170HX,再配 64 GiB 或 128 GiB 主机内存做换回层,短解码可以沿用我们在这张 64 GB 卡上测到的数字:24 路合计 992 tok/s,单路大约 94 到 129,长文读入大约 2300 到 2500 tok/s。换回层加大,不会让这组短解码更快,也不会提高 24 路短输出的总吞吐。
它改变的是长上下文能留下多少、被挤出去之后要不要整段重算。40 GB 的卡上,GPU KV 池实测大约 19.37 GiB、29 万 token。64 GB 的卡装完同样大约 16 GiB 的权重后,留给 KV 的空间大约多出二十多 GiB。按同样的每 token 显存密度推算,GPU 池大约能到 60 万 token 这一档。这是推算,不是另一次读下来的池子数字。按 262K 上限,大约能同时在 GPU 里热着 2 段接近上限的上下文;40 GB 的卡大约只够 1 段。
| 组合 | 短解码(实测) | GPU 上大约能同时热着 | 内存里大约能接着放 | 日常被挤出后 |
|---|---|---|---|---|
| 64 GB 卡 + 64 GiB 内存层 | 24 路合计 992 tok/s | 约 2 段接近 262K | 约 3 段接近 262K | 通常走内存,不必落磁盘 |
| 64 GB 卡 + 128 GiB 内存层 | 同样是 992 tok/s | 约 2 段接近 262K | 约 7 段接近 262K | 通常走内存,不必落磁盘 |
也就是说,64 GiB 内存层时,大约 2 段在 GPU 上解码、大约 3 段在内存里等着,加起来大约 5 段长上下文不用整段重算;128 GiB 内存层则大约是 2 加 7,一共大约 9 段。这些空闲前缀不能同时在 GPU 里跑满,只是再请求时可以较快接上。两边都还可以把磁盘留下来接溢出,以及在进程重启后把前缀读回来。
要做到类似配置,大概需要这些条件
显存要先能放下大约 16 GiB 的 W4A16 权重,再给 KV 和运行开销留空间。64 GB 的 CMP170HX 测吞吐更宽裕。40 GB 的卡也能装下权重,并开到 262K 上下文,只是 GPU 上的 KV 池会小一截,大约是 19 GiB、29 万 token 这个量级。
如果要做长前缀换回,主机内存需要单独留出一块给换回层。14 GiB 能覆盖大约 20 万 token;只留 4 GiB,大约只能覆盖 6 万 token,再长就会整段重算。如果是 64 GB 的卡再配 64 GiB 内存层,按比例大约能放 98 万 token,一般大于这张卡上大约 60 万的 GPU 池,日常被挤出的前缀可以只走内存;再配 128 GiB 内存层大约 197 万 token,内存里大约能同时留下大约 7 段接近 262K 的空闲前缀。磁盘依然值得留着,用来接住超出内存的部分,以及在进程重启后把前缀读回来,所以还是需要一块能跟得上的 NVMe。
软件上是 vLLM,MTP1,预编译加速图覆盖到批大小 128,读入块 8192,上下文 262K。若要同时开 MTP 和 KV 换回,需要 vLLM 0.30 或更新的版本。
短解码更受显存带宽影响;模型加载和换回则更看主机内存和磁盘。核心偏移我们定在 +150,满载功耗大约 300 W。再往上的偏移我们测过,稳定性不够,没有采用。
质量
中文、代码和推理是我们用来对比 MTP 深度、也用来做满载校验的三组题目。稳定配置满载 1 小时,输出校验每次都对得上。MTP4 之所以不用,就是这三组输出跟基准不一致。
这不是对 BF16 的正式评测,也不能据此说无损。
测试口径:自测数据来自 2026 年 11 月。992 tok/s 指单张 64 GB CMP170HX,在 MTP1、核心偏移 +150、24 路并发、热态短解码下的合计输出吞吐。不是单路速度,也不是预填充速度,更不是把排队、预填充和首字时间都算进去的端到端指标。单路通常约 94–129 tok/s。长文读入约 2300–2500 tok/s。MTP 对比数字来自定配置时的测试;并发表是后来在稳定偏移下测的。换回数据来自 vLLM 0.33、14 GiB 内存层加 NVMe 的配置:200K 冷启动 169.05 秒,挤出后载回 15.99 秒、命中 198400;64K 冷启动 35.34 秒,载回 5.68 秒、命中 62400。64 GiB / 128 GiB 内存层大约能放 98 万、197 万 token,是按 14 GiB 实测大约 21.5 万 token 的比例估算的;64 GB 卡的 GPU 池大约 60 万 token,是按 40 GB 卡上 19.37 GiB / 29 万 token 的密度,扣除同样大约 16 GiB 权重和相近运行开销后推算的。这两项都不是另一次实测。262K 是上下文上限,不代表这些并发测试填满了该长度。质量结论只来自抽查和满载校验。