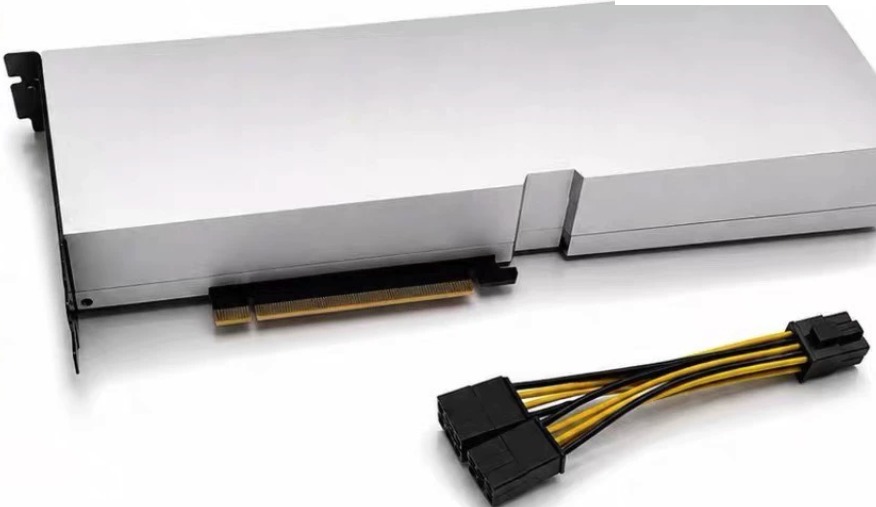
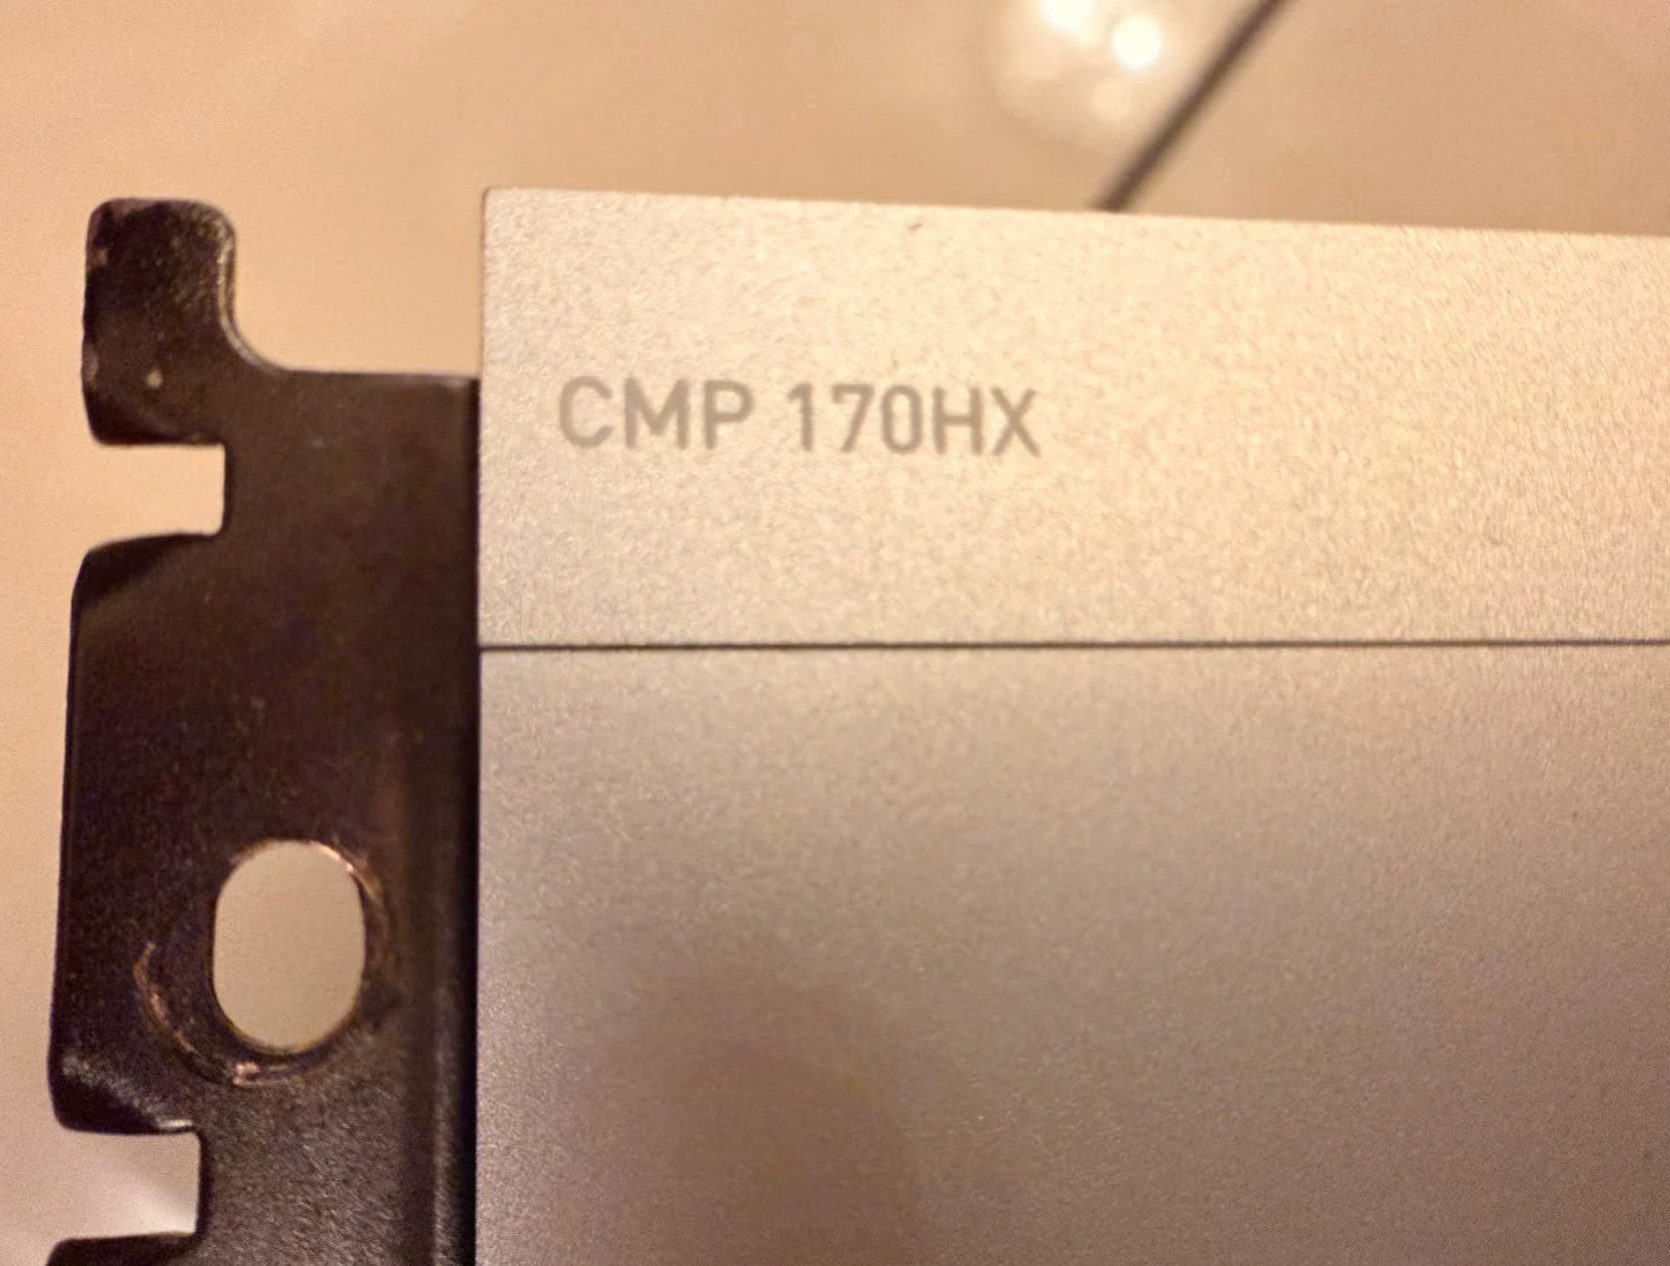
Qwen3.8-Flash-Next 大约是 125B 的 MoE。我们用 ElectroHobo 的 3bpw 方案,在一张 64 GB 的 CMP170HX 上跑它。热态、短输出、24 路并发时,解码总吞吐第一轮是 989 tok/s,第二轮是 1107 tok/s。单路大概 150 到 180 tok/s。
那个大约 1000 tok/s,是 24 路加在一起的数字,不是一条请求自己每秒能写出一千个 token。
64 GB 里实际放了什么
量化是 AutoRound 的混合 2/3-bit,也就是常说的 3bpw,不是 W4A16。权重装进显存大约 47 GiB,这张 64 GB 卡几乎铺满,大概还剩 2 GiB。上下文开到 262K。
后来看过一次 GPU 上的 KV 池:大约 7.47 GiB,能放下大约 294486 个 token,合每个 token 大约 27 KB。前面说的大约 2 GiB,是权重就位之后卡上剩下的空间,不是整个 KV 池只有这么大。262K 是单路上下文能开到的量级,并不表示 24 路可以各自填满 262K,还能维持后面那些吞吐数字。
这条栈还有一块大约 48 GiB 的 FP8 PLE 查找表,放在主机内存里。所以这里的“单卡”指计算走一张 GPU,不是整套工作集都在显存里。
解码用了 DFlash2:大约 1 GiB 的草稿模型先提出候选 token,再交给主模型验证。猜中了,主模型就可以少算一段。收益会随输出内容和并发变化,不能把某一类短输出的速度套到所有任务上。底下的推理框架是 vLLM。公开的单卡方案在 ElectroHobo 的 3bpw 食谱。
换栈之前,并发几乎加不上去
切服务之前,我们在同一张卡上用同一套方法对比过三套栈:
| 项目 | Strata | ExLlamaV3 | ElectroHobo |
|---|---|---|---|
| 单路解码 | 约 115 tok/s | 约 103 tok/s | 约 159 tok/s |
| 8 路总解码 | 约 117 tok/s | 约 148 tok/s | 约 542 tok/s |
| 16 路总解码 | — | 约 112 tok/s | 约 878 tok/s |
| 8K 预填充 | 约 1415 tok/s | 更慢,未单列 | 4000+ tok/s |
| 262K 上下文 | 能开 | 能开 | 能开 |
Strata 单路大约 115 tok/s,开到 8 路,总量还是大约 117。请求变多了,卡并没有吐出更多 token。ExLlamaV3 的 8 路略好(大约 148),16 路反而掉到大约 112。ElectroHobo 单路大约 159,8 路大约 542,16 路大约 878;8K 预填充也从大约 1415 走到 4000 以上。
后来切过去再测一次:单路大约 150 tok/s,8 路总量大约 558,16 路大约 842,8K 预填充大约 4600 tok/s。满载时大约 260 W、46°C,核心偏移保持 +150。
热态短解码:同一口径测了两轮
预填充是读提示词,解码是往外生成。长文本问答往往会先花时间在读入和等待第一个 token 上,所以这两类数字要分开看。
下面两轮测的是热态、短输出的解码总吞吐,KV 卸载开在 24 GB。两轮之间没有改配置,也没有重启服务。
| 并发 | 第一轮 | 第二轮 |
|---|---|---|
| 1 路 | 147 tok/s | 181 tok/s |
| 16 路 | 871 tok/s | 874 tok/s |
| 24 路 | 989 tok/s | 1107 tok/s |
16 路几乎没动,871 和 874。有起伏的是单路(147 到 181)和 24 路(989 到 1107)。我们没有把这个差值钉到某一个原因上,更像同一口径下的正常波动。对外说大约 1000 tok/s,比单独引用 1107 更合适。
也别把它读成 24 路各自带着满上下文在跑。这次测的是短输出的解码吞吐,262K 只是服务开着的上下文上限。
要做到类似配置,大概需要这些条件
显存要先能放下大约 47 GiB 的 3bpw 权重,再给 KV 和运行开销留空间。这次用的是 64 GB 的 CMP170HX,权重就位后大约剩 2 GiB。
主机内存要能放下大约 48 GiB 的 PLE 表。只买一张卡、内存不够,这条加速路径走不通。
软件上就是 vLLM 加 DFlash2 的 3bpw 方案,上下文按 262K 开。
总线方面,单卡解码更受显存带宽影响;模型加载、访问主机上的查找表,以及以后如果做跨卡,PCIe 会更敏感。
更高一档是 W4A16,权重大约 60 多 GiB。公开方案按两张 64 GB 卡、Gen2 x16 加卡间直连来做,见 ElectroHobo 的 W4A16 食谱。本文测的是单卡 3bpw,不是那条路。
质量和其他人的数字
中文、代码和推理我们抽查过,和原来的 Strata 比,没有看到明显下降。这不是对 BF16 的正式评测,也不能据此说无损。图也能看:OCR、形状和颜色、一张 2000×1500 的图,还有一张实际图表,都只是功能抽查。
作者公布的 3bpw 数字是:单路写代码大约 296 tok/s,8 路总量大约 791,48 路 1384,预填充大约 4243。那是作者自己的环境和题目。我们的单路明显低一些;24 路 1107 和他们的高并发总量只是量级接近,并发数和负载都不同,不好直接比高低。
测试口径:自测数据来自 2026 年 11 月。约 1000 tok/s 指单张 64 GB CMP170HX,在 24 路并发、热态短解码下的合计输出吞吐:第一轮 989,第二轮 1107。不是单路速度,也不是预填充速度,更不是把排队、预填充和首字时间都算进去的端到端指标。单路通常约 150–180 tok/s。三栈对比是同一套方法;热态短解码的两轮单独列出,KV 卸载为 24 GB,两轮之间未改配置、未重启服务。262K 是上下文上限,不代表这些并发测试填满了该长度。质量结论只来自抽查。