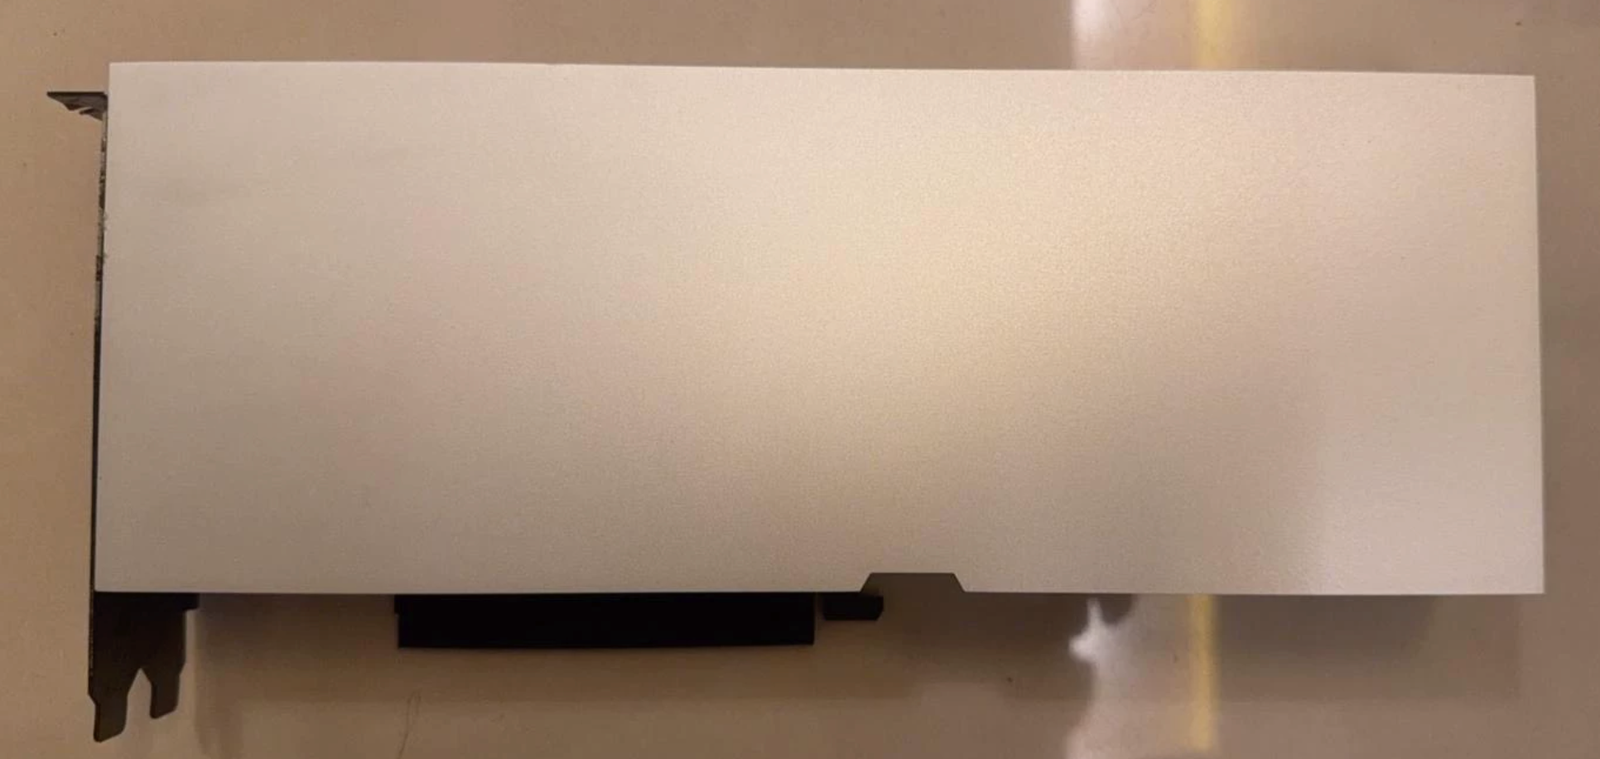
24 路合计 992 tok/s:CMP170HX 上的 Qwen3.8-27B
Qwen3.8-27B 是大约 27B 的密集模型,混合了注意力和 Mamba。我们用 vLLM,在一张 64 GB 的 CMP170HX 上跑它的 W4A16。热态、短输出、24 路并发时,解码总吞吐是 992 tok/s,平均每路大约 54 tok/s。单路大约 94 到 129 tok/s。 ...
Qwen3.8-27B 是大约 27B 的密集模型,混合了注意力和 Mamba。我们用 vLLM,在一张 64 GB 的 CMP170HX 上跑它的 W4A16。热态、短输出、24 路并发时,解码总吞吐是 992 tok/s,平均每路大约 54 tok/s。单路大约 94 到 129 tok/s。 ...
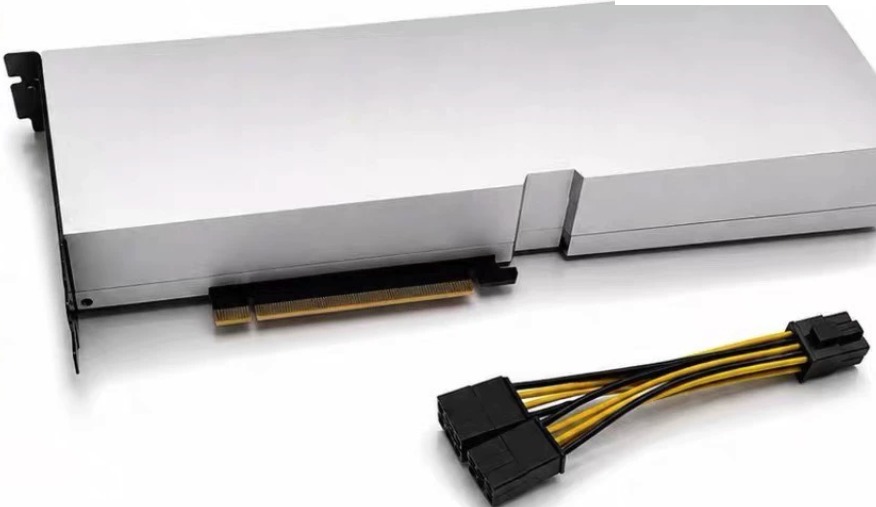
Qwen3.8-Flash-Next 大约是 125B 的 MoE。我们用 ElectroHobo 的 3bpw 方案,在一张 64 GB 的 CMP170HX 上跑它。热态、短输出、24 路并发时,解码总吞吐第一轮是 989 tok/s,第二轮是 1107 tok/s。单路大概 150 到 180 tok/s。 ...